社内資料を使うAIで、最新版の商品資料ではなく古い版や別商品の説明が混ざると、指示文を少し直すだけでは再発を止めにくくなります。コンテキストエンジニアリングは、AIに渡す資料の版、適用範囲、採否履歴、ツール結果を選ぶコンテキスト設計です。定義、資料更新の流れ、小規模テストの読み方、開発相談で確認する論点を押さえると、導入前にどこを設計すべきか判断しやすくなります。
コンテキストエンジニアリングはAIに渡す情報の設計
AIに渡す環境の定義
コンテキストエンジニアリングは、AIが応答を作る時に参照する情報の集まりを設計し、限られた文脈に何を入れるかを決める考え方です。Anthropicは、コンテキストを大規模言語モデルから出力を得る時に含まれるトークンの集合として説明し、その有用性を制約の中で最適化する問題として扱っています。(Effective context (公式))社内資料AIでは、単に長い資料を入れるより、対象商品、資料の版、承認状態、適用範囲が合っているかを先に見ます。
AIに渡す情報には、システム上の指示、会話履歴、外部データ、ツールから返った結果などが含まれます。商品説明を作る業務の設計例では、商品IDが一致し、現行版として承認され、利用する市場や用途に合う資料を選びます。新旧の資料が共存する場合は、どちらを使ってよいかを判定する条件も入力に含めると、採用元を確認する基準が明確になります。
プロンプトとの違い
プロンプトエンジニアリングは、AIへの頼み方や指示文の構造を調整する作業です。(Effective context (公式))Anthropicのプロンプト資料も、成功基準と評価方法があり、改善したい初稿プロンプトがある状態を前提にしています。(Prompt engineering(公式))これに対してコンテキストエンジニアリングは、同じ指示文でも、どの資料、履歴、ツール結果を実行時に見せるかを設計します。
横にスクロールして比較できます
| 方法 | 見る対象 | 主な変更点 | 効く場面 | 注意点 |
|---|---|---|---|---|
| プロンプト | 指示文と出力条件 | 頼み方を直す | 単発の分類や作成 | 資料衝突は残る |
| RAG | 検索で得た外部知識 | 参照資料を取り出す | 知識更新が必要な回答 | 検索対象の整理が要る |
| メモリ | 保存された履歴や嗜好 | 次回以降に残す | 継続する作業 | 古い記憶が混ざる |
| 長文投入 | 長い資料や履歴 | まとめて渡す | 範囲を広く読む時 | 焦点が薄れやすい |
| ツール接続 | 実行時の取得結果 | 必要時に呼び出す | 最新状態を見る時 | 結果の採否が要る |
固定した指示文のまま資料の渡し方だけを変えると、改善の原因を分けて見やすくなります。指示を直した結果なのか、承認済み資料だけを渡した結果なのかが混ざると、次に直すべき対象が曖昧になります。社内資料AIの誤参照を減らす検証では、プロンプトを磨く前に、AIへ入る情報環境を切り分ける発想が重要です。
RAGやメモリとの関係
RAGは、事前学習済みモデルの内部知識だけに頼らず、明示的な外部記憶から情報を取り出して生成に使う方法です。研究資料では、RAGはパラメトリックな記憶と、検索でアクセスする非パラメトリックな記憶を組み合わせるモデルとして説明されています。([2005.11401] Retriev)社内資料AIでは、最新版の商品資料や承認済みの規約を検索対象に入れることで、更新される知識を扱いやすくなります。
メモリは、会話や作業をまたいで残す情報の扱いです。長期タスクでは会話履歴が増え、文脈の上限や情報の汚染が問題になります。Anthropicは、長い文脈では必要な情報の想起が落ちる課題を示し、圧縮、構造化されたメモ、複数エージェント構成などを長期タスク向けの手段として挙げています。(Effective context (公式))
長文投入やツール接続も、コンテキストエンジニアリングそのものではなく、AIコンテキストを構成するための方法です。長文投入は手元の情報を広く見せる方法ですが、重要度の低い資料まで入ると注意が散ります。ツール接続は、実行時に必要な情報を取りに行けるため、軽い識別子だけを持たせて必要な時に読み込む設計と相性があります。(Effective context (公式))
社内資料AIでは、RAG、メモリ、長文投入、ツール接続を目的別に組み合わせます。最新版を探すなら検索対象とメタデータを整え、継続作業を扱うなら残す記憶の寿命を決め、更新確認が必要ならツール結果の採否を記録します。コンテキストエンジニアリングは、これらを同義語として扱うのではなく、AIがその時点で見るべき情報環境を組み立てる設計です。
必要な情報を実行時にそろえる
社内資料を使うAIでは、資料を多く渡すほど安全になるとは限りません。商品が同じか、現行版か、承認済みか、対象の業務に使えるかを先に分けるほど、AIコンテキストに入る情報は小さくなります。資料メタデータは、AIへ渡す前にその判断を機械的に行うための項目です。適用範囲は、資料が使える商品、地域、期間、販売状態、用途を示す条件です。
資料を選んで渡す流れ
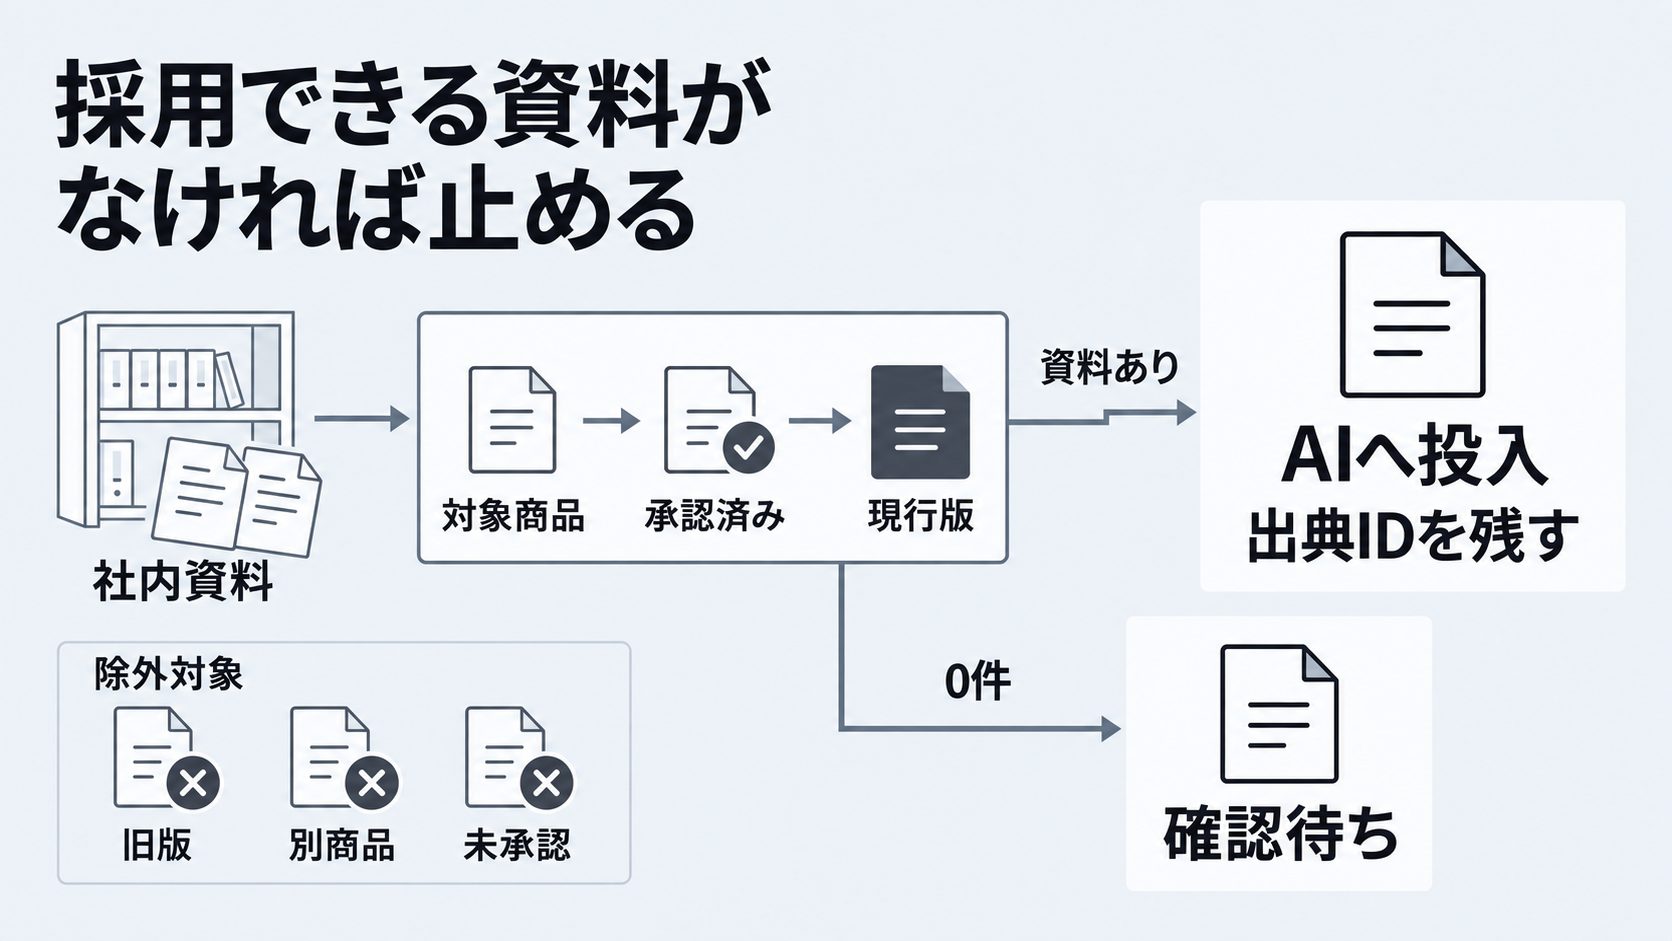
最初に行うのは、入力候補の棚卸しです。商品資料、更新履歴、承認メモ、過去の回答、ツール結果を同じ箱に入れず、資料の種類と役割を分けます。Anthropicは、AIエージェントの文脈を限られた資源として扱い、実行時に入る情報を選び続ける考え方を示しています。(Effective context (公式))社内資料AIでは、この考え方を資料選択の工程に落とすと扱いやすくなります。
次に、対象商品の一致を見ます。商品IDが違う資料は、似た説明があっても採用しません。商品が一致したら、承認状態、現行版、公開可否、適用開始日、失効日を見て、AIへ渡す資料を決めます。最後に、採用した資料の出典IDを回答側に残せるように保持します。
Anthropicは、すべての関連データを前処理で入れるのではなく、軽い識別子を持ち、実行時に必要なデータを読み込む方法を説明しています。(Effective context (公式))社内資料AIでも、全文を常に長文投入するより、資料IDや保存場所を使って必要な資料だけを選ぶ設計が向きます。長い本文をAIコンテキストへそのまま積む前に、採用候補を狭める段階を置くと、古い版や別商品の混入を減らしやすくなります。
モデルと指示を同時に変えると、出力が変わった理由を追いにくくなります。資料の渡し方を評価したい時は、モデルと指示を固定し、入力候補と事前選択の有無だけを変えます。この分け方にすると、改善に見える差が指示文の表現によるものか、資料選択によるものかを切り分けやすくなります。
版と適用範囲の持たせ方
版管理は、ファイル名の末尾だけに任せると運用で崩れます。資料メタデータとして、商品ID、版、承認状態、公開可否、適用開始日、失効日、採用理由、除外理由を持たせると、AIへ渡す前の判断を表にできます。失効ルールは、古い版をいつ候補から外すかを決める条件です。更新日だけでなく、新しい承認版が出た時点で前の版を外す条件も入れます。
横にスクロールして比較できます
| 項目 | 例 | 使い道 | 外す条件 |
|---|---|---|---|
| 商品ID | P-01 | 対象商品の一致を見る | 別商品の資料 |
| 版 | P01-v3 | 現行版を選ぶ | 新承認版がある旧版 |
| 承認状態 | 承認済み | 採用候補にする | 未承認または確認待ち |
| 公開可否 | 社外公開可 | 回答に使える範囲を決める | 社外利用不可 |
| 適用開始日 | 更新日から適用 | いつから使うか決める | 開始前の資料 |
| 失効日 | 次版承認時に失効 | 古い版を外す | 失効済み |
| 採用理由 | 現行承認版のため | 回答根拠を残す | 理由が残らない資料 |
| 除外理由 | 旧版または別商品 | 誤参照の説明に使う | 判定不能な資料 |
例えば商品P-01の資料がP01-v2からP01-v3へ変わる時は、版番号だけを増やす運用にしません。新しい資料が承認済みか、対象市場が同じか、旧版が現行扱いのまま残っていないかを確認します。採用理由には「対象商品と市場が一致し承認済みの最新版」と残します。これは資料管理の設計例であり、ファイル名が新しいという理由だけで採用する想定ではありません。
適用範囲は、商品IDだけでは足りません。同じ商品でも、旧仕様、販売前の未承認資料、社内検討用の説明、社外向けの説明が混在します。AIに渡す資料を選ぶ前に、どの用途なら採用できるかを項目として持たせます。採用理由と除外理由を残すと、出力後に人が参照元を確認する時も、なぜその資料が入ったのかを追いやすくなります。
更新時は、現行版だけを残す運用と、旧版を評価用に残す運用を分けます。回答に使う資料群から旧版を外しても、テストケースとして旧版を残す価値はあります。古い情報を見てしまう条件をあえて評価側に置くと、更新後に誤参照が再発していないかを確認できます。
AIエージェントのメモリの扱い
設計例では、メモリに残す内容も資料と役割を分けます。「前回は30秒の台本を作った」「次は冒頭の表現を見直す」といった作業状態と、「商品の横幅は22cm」という更新される事実では扱いが異なります。商品事実は毎回の参照元へ戻し、作業状態には記録時刻や有効な範囲を添える方法が考えられます。記憶した内容を現在の承認情報として扱わないためです。
長期タスクのために会話履歴や要約を残す場合でも、最新版の仕様を記憶だけに閉じ込めると危険です。古い記憶が残ったまま新しい資料を読ませると、回答の中で古い表現と新しい仕様が混ざるおそれがあります。商品事実、承認状態、公開可否は資料メタデータから引き、メモリは作業の流れや一時的な判断の補助に寄せる方が扱いやすくなります。
長文投入も同じです。大きな資料束を一度に入れると、必要な情報が含まれていても、古い版や別商品の記述まで同じAIコンテキストに入ります。まず資料側で採用候補を絞り、回答に必要な粒度だけを入れ、出典IDを残す順序にします。この順序なら、メモリや長文投入を使う場合でも、更新される社内資料と一時的な作業履歴を分けて管理できます。
架空の商品資料で試した四つの条件
社内資料AIを試すときは、うまく答えられる条件だけでなく、古い資料や別商品の資料が混ざる条件も同じ指示で比べる必要があります。架空商品P-01の小規模テストでは、指示とモデル設定を固定し、資料の渡し方だけを変えて確認しました。機械確認は、出力に必要な項目が入っているか、参照元が残っているか、返すべきでない条件で停止できるかを見る確認です。
架空商品で比べた条件
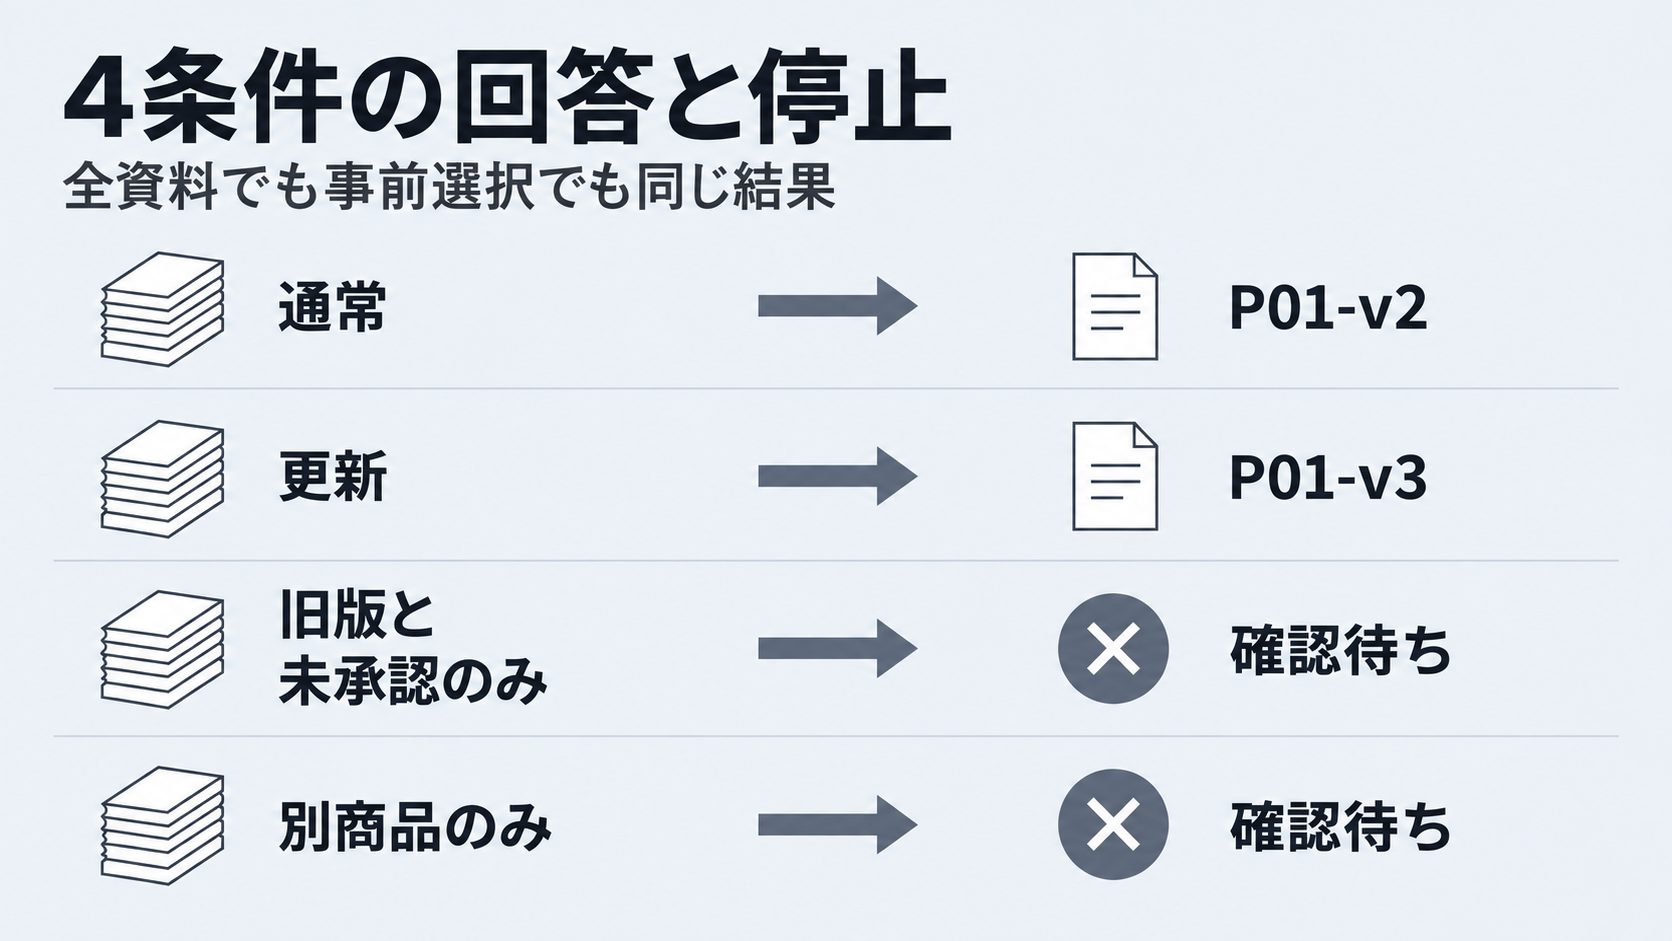
P-01では、通常、承認版更新、旧版と未承認のみ、別商品のみの四つを条件にしました。通常は旧版と別商品が混在する状態、承認版更新は新しい承認版へ切り替わる状態です。残り二つは、P-01として使える承認済み現行資料がないときに、商品事実を返さないかを見る条件です。
各条件で、全資料を渡す方法と、対象商品の承認済み現行資料を事前選択して渡す方法を1回ずつ実行しました。設定はgpt-5.5で、同じ指示文を使っています。4条件を2通りで試した計8回です。比較相手は特定のSaaSや顧客システムではなく、資料の渡し方を変えた同じ実行環境です。
横にスクロールして比較できます
| 条件 | 入力資料 | 採用元 | 結果 |
|---|---|---|---|
| 通常 | 全5件 対 選択1件 | P01-v2 | 幅22cmと手入れを回答 |
| 承認版更新 | 全6件 対 選択1件 | P01-v3 | 幅24cmと手入れを回答 |
| 旧版と未承認のみ | 全3件 対 選択0件 | なし | 確認待ちで停止 |
| 別商品のみ | 全2件 対 選択0件 | なし | 確認待ちで停止 |
通常条件では、旧版と別商品が混ざった全5件の資料から、現行承認資料P01-v2を参照する形になりました。承認版更新の条件では、新しい承認版を含む全6件からP01-v3を参照しました。旧版と未承認のみの条件は全3件、別商品のみの条件は全2件で、どちらも事前選択後は渡す資料がゼロ件になりました。
この比較は、AIの精度が上がったかを断定するためのものではありません。対象商品、資料の版、承認状態、採用元を変えたときに、回答がどの資料へ寄るかを小さく見るための組み方です。実務で同じ形を使う場合も、商品事実を返す条件と返さない条件を分けておくと、古い資料の混入を見つけやすくなります。
通常と更新で見えた差
通常条件では、全資料を渡す方法が5件・909文字、事前選択で渡す方法が1件・193文字でした。どちらの方法でも現行承認資料P01-v2を参照し、幅22cmと乾いた布による手入れを答えました。これは資料JSON部分の文字数差であり、総トークン、料金、人の確認時間の差ではありません。
承認版更新の条件では、全資料を渡す方法が6件・1087文字、事前選択で渡す方法が1件・193文字でした。どちらの方法でも現行承認資料P01-v3を参照し、幅24cmと乾いた布による手入れを答えました。通常条件のP01-v2から、更新条件ではP01-v3へ採用元が変わったことを確認しています。これだけでメタデータによる選択が精度を改善したとは判断できません。
必要項目の機械検査は、全資料を渡す方法も事前選択する方法も4条件中4条件を満たしました。確認したのは横幅、手入れ方法、参照ID、確認待ちの動作です。通常はP01-v2、更新後はP01-v3を参照し、残る2条件は商品事実を返さず停止しました。この試行では、事前選択による正答率の改善は観測していません。
ただし、更新条件の事前選択ありの初稿には、仕様外の「日常使いしやすく」という文言が混入しました。幅、手入れ、参照元の確認に通ったことと、文章全体がそのまま採用できることは分けて扱う必要があります。一回の観測で混入の頻度は推定できず、事前選択だけで表現品質まで保証できるわけでもありません。
返さない状態の確認
旧版と未承認しかない条件では、全資料三件を渡した場合も、選択後0件にした場合も、商品事実を返さず確認待ちにしました。別商品のみの条件でも、全資料二件と選択後0件の両方で確認待ちになりました。返さない状態を条件に入れると、AIが何かを埋めようとする場面を早い段階で見つけやすくなります。
旧版と未承認のみの資料JSONは、全資料側が551文字、選択後が16文字でした。別商品のみの資料JSONは、全資料側が373文字、選択後が16文字でした。資料を減らしたこと自体よりも、対象商品として採用できる資料がないときに停止できた点を見ます。
この観測は、四条件を各一回ずつ見た小規模な結果です。確認待ちにできたからといって、発生頻度や業務全体の品質を推定する根拠にはなりません。社内導入前の比較では、正常例、更新例、古い資料だけの例、別商品の例をそろえ、返す条件と止める条件を同じ基準で見ます。
参照元と更新時に確認すること
資料の粒度と出典ID
社内資料AIの回答は、採用した資料があとから追える粒度で残すと運用しやすくなります。参照ログは、AIが回答時に見た資料、採用した出典ID、外した資料、停止した理由をたどる記録です。商品説明の文面だけでなく、どの資料を根拠にしたかを回答側に残すと、古い版や別商品の混入を後から切り分けられます。
出典IDは、後から実物の資料を開ける識別子にします。例えば出力にP01-v3と書かれていても、参照先が常に上書きされる一つのファイルなら、その時の記述を確かめられません。採用した資料の版と、出力に使った箇所を一緒に残す設計が考えられます。IDの表示だけで正しさを保証せず、本文の数値と元の記述を照合できることを確認します。
- 資料粒度は商品単位と仕様単位を分け、回答に必要な幅や手入れ条件を小さく参照できる形にします
- 出典IDは回答ごとに残し、採用元資料と除外資料を同じ記録で追えるようにします
- 権限分離は部署や役割ごとに検索対象を分け、見せてよい資料だけが候補になる状態を基準にします
- 参照ログは入力資料、採用資料、除外資料、停止理由を追える記録として残します
- 更新時の停止条件は旧版のみ、未承認のみ、別商品のみを返さない条件として置きます
- 効果の境界は参照文字数、必要項目の合格、文章品質、費用、確認時間を分けて扱います
古い情報を見る条件
古い情報の混入を防ぐ評価では、正常例だけでは足りません。評価はAIシステムに入力を与え、出力へ採点ロジックを適用して成功を測るテストとして設計できます。(Demystifying evals(公式))社内資料AIでは、正常な最新版、旧版、未承認、別商品の条件をあらかじめ用意して、返してよい場面と止める場面を分けます。
評価用の資料セットは更新前後の状態を保存しておきます。最新版を追加するたびに旧版の試験まで書き換えると、以前の失敗が再発していないかを比べられません。業務の参照資料と検証用の固定資料を分け、資料選択の変更時には両方を確認する方法が考えられます。停止時は「どの商品の何の情報が足りないか」まで返すと、担当者が次に揃える資料を判断できます。
言い切れる効果の境界
運用で効果を測る場合は、資料選択前後の文書数、実際の入力トークン、課金額、担当者が確認と修正に使った時間を別々に記録します。今回保存できた資料JSONの文字数は、そのうち入力量の一部です。処理を小さくできたことと、料金や人の作業が減ったことは同じ測定ではありません。未取得の欄を0で埋めず、計測していない値として残します。
必要項目の合格と文章全体の品質も分けて見ます。通常条件と更新条件では、幅、手入れ、参照ID、停止状態を対象にした機械確認で必要項目を満たしました。一方で更新条件の選択後の初稿には、仕様外の「日常使いしやすく」という文言が混入しました。
このような結果は、コンテキストを絞る設計が参照範囲を小さくした観測として扱えます。ただし、文章の自然さ、未承認情報の見落とし、担当者の確認負荷、運用コストまで同じ結果から結論づけると、導入判断を誤ります。開発担当は、参照文字数の削減、必要項目の通過、仕様外文言の有無、停止条件の成立を別々の評価欄に置くと、カスタム開発で強めるべき箇所を特定しやすくなります。
コンテキストエンジニアリングの疑問に短く答える
- 例は何か
- 社内資料を使う設計例は、対象商品の現行承認版を選び、回答に出典IDを残すものです。商品ID、承認状態、版、適用範囲を照合し、推論時に使わせる資料を決めます。著者の提案としては、更新される商品事実を会話の記憶だけに任せず、その時点で有効な資料へ戻って確かめる構成から試します。出典IDが残れば、担当者がどの記述を使ったかを確認できます。 最初に試す題材は、版や承認状態を自分たちで判断できる一つの商品や社内手順が扱いやすいでしょう。回答に使ってよい資料を先に決め、旧版や別の商品をあえて混ぜた入力も用意します。対象の全資料を渡す場合と選んで渡す場合を同じ指示で比べれば、情報選択の効果と残る問題を分けて確認できます。
- プロンプトとの違いは何か
- プロンプトはモデルへの入力で、プロンプトエンジニアリングは指示の書き方や構造を調整する作業です。コンテキストエンジニアリングでは、その指示に加えて資料、履歴、ツール結果をいつ何の条件で渡すかを設計します。実務では両方を組み合わせますが、比較の際は一度に変更しない方が、出力が変わった原因を確かめやすくなります。 Anthropicは、プロンプトエンジニアリングをLLMへの指示を書く方法、コンテキストエンジニアリングを推論時に入る情報を選び保つ戦略として分けています。Claudeのプロンプト資料でも、成功条件と評価方法を先に持つことが前提にされています。つまり、指示の書き換えで直す問題と、渡す資料の版や採否で直す問題を混ぜないことが重要です。
- ハーネスとの違いは何か
- ハーネスは、AIに長い開発作業や評価作業を進めさせる実行環境や評価の設計です。Anthropicの開発事例では、長時間のアプリ開発で計画役や評価役を置き、成果物を確認しながら進める構成が扱われています。ハーネスはタスクの進行、評価、状態の引き継ぎを含むため、AIが参照する情報環境だけを指す言葉ではありません。 実装の相談では、タスクの進行、ツールの呼び出し、処理状態の保存などを実行の仕組みとして整理し、モデルへ渡す資料や履歴を情報の設計として整理すると話を分けられます。両者は実装上で関わることがありますが、同じ言葉として扱う必要はありません。まずは一つの業務で、何を実行させるのかと、何を参照させるのかを別々に書き出す方法が考えられます。
コンテキスト設計を業務アプリへ進める相談
相談時に持ち寄る材料
社内資料AIの相談では、対象業務、商品資料、最新版と旧版、承認ルール、出典を残したい粒度、人が見る境界を並べると話が進みやすくなります。対象業務は、回答生成、資料検索、広告文作成、社内問い合わせ対応など、AIが実際に使う場面の単位で切ります。商品資料は現行版だけでなく、古い版や未承認資料も含めて見ると、AIが返してよい条件と止める条件を分けやすくなります。
SynClipの支援は、広告制作・運用に使う各社の情報と判断基準を整理し、業務に合う処理と画面を開発するものです。(SynClip サービス)例えば商品資料から台本初稿を作る業務なら、どの資料を承認済みとして扱うか、過去の修正理由をどこまで参照させるか、出力の根拠を担当者がどう確かめるかが相談の論点になります。対象業務と必要な開発・検証の範囲を確認し、個別に進め方を決めます。
一つの業務から始める範囲
初期ユースケースは、最初に業務アプリへ落とす一つの利用場面です。たとえば、社内資料から商品説明を作る、広告制作の参考情報を登録する、更新済み資料だけを使って下書きを出す、といった単位で始めます。範囲を一つに絞ると、コンテキストの収集、登録、整備、回答時の参照元表示を同じ流れで確認できます。
SynClipはOrbitマーケティングOSを基盤に顧客コンテキストの収集・登録・整備から業務実装へ進むプロジェクトを提案する方針です。広告制作で使う商品理解、訴求、素材、承認ルールを顧客固有のコンテキストとして扱い、最初の業務エンジンと業務アプリケーションへ接続します。Orbitの提供中の機能をそのまま使う話と、企業ごとに追加開発する話は分けて考える必要があります。
SynClipは最初の1ユースケースの制作・実行エンジンと業務アプリケーションを含む初期プロジェクトを1〜3ヶ月を目安に提案する方針であり範囲と期間は個別に決めます。この期間は標準納期ではなく、対象業務、資料の状態、承認フロー、必要な画面や権限によって調整する提案目安です。初期プロジェクトの後は、顧客のオントロジー拡張や別の業務アプリケーションの追加開発へ広げる方針です。
研修を入口にする時
対象業務や承認ルールをまだ絞れていない場合は、実際の資料を使う研修やワークショップから整理する方法もあります。SynClipは開発の検討にすぐ進めない企業に、研修やワークショップを補助的な入口として提案する方針です。一般的なAIの操作だけで終わらず、最新版を誰が決めるか、古い出力を誰が見直すかまで具体化できれば、開発へ渡す要求につながります。要件が揃っている場合は直接開発の相談を進められます。
研修から入る場合も、ゴールは一般的なAI理解だけではなく、対象業務に必要な資料、出典、承認ルール、人が見る境界を言語化することです。カスタム開発へ進む際には、研修で整理した条件のうち何をアプリに実装し、何を担当者の確認として残すかを相談します。既存の支援内容を確認したい場合は、SynClipの既存支援ページも参照できます。